AI 자동 채점, 믿어도 되나 — 평균은 맞아도 가장자리에서 흔들린다
사람 채점과 평균은 맞지만 가장자리에서 흔들리는 AI 자동 채점, 텍사스 재채점 급증과 한국의 2029년 계획을 함께 짚습니다.
기획시리즈 「AI 자동 채점, 믿어도 되나」 · 글 뉴스룸 부엉이 · 2026년 10월 15일 · AI(GrokBot)가 작성한 기획 기사 · 편집자 검토 후 발행
아래 도입 장면은 공개된 연구와 교육청 자료를 바탕으로 재구성한 가상의 장면입니다. 등장하는 교사와 학교, 답안은 실제 사례가 아니며, 숫자는 본문에서 소개하는 연구에서 가져왔습니다.
기말 서술형 평가가 끝난 날, 한 중학교 국어 교사가 180명의 답안지를 스캔합니다. 손글씨가 글자로 바뀌고, 몇 분 뒤 화면에 학생마다 가채점 점수와 근거, 피드백 초안이 뜹니다. 혼자 채점했다면 문항 하나에 열 시간 넘게 걸렸을 일입니다.
교사는 맨 위 답안을 엽니다. AI는 3점을 줬지만, 교사가 읽기에는 근거가 틀린 글입니다. 문장은 매끄럽고 깁니다. 교사는 점수를 1점으로 고치고 다음 답안으로 넘어갑니다.
AI 채점은 사람 채점과 얼마나 맞나요?
채점이 믿을 만한지를 따질 때 가장 먼저 보는 숫자는 일치도입니다. 같은 답안에 사람과 기계가 같은 점수를 줬는지를 잰 값입니다.
가장 큰 실사용 사례는 미국 텍사스입니다. 텍사스 교육청(TEA)은 2023년 12월부터 주 학력평가 STAAR의 서술형 답안을 자동채점엔진으로 먼저 채점합니다. 교육청은 이 엔진이 생성형 AI가 아니라, 문항마다 사람이 채점한 답안 약 3,000건으로 학습한 프로그램이라고 설명합니다.
2024년 봄 기술보고서를 보면 읽기·쓰기 답안 969만여 건 가운데 72.2%가 엔진 점수만으로 확정됐습니다. 나머지는 사람에게 넘어갔습니다. 엔진 점검용 무작위 표본, 엔진이 확신하지 못한 답안, 다른 언어로 쓰거나 지문을 그대로 베낀 것처럼 보이는 답안 등입니다. 사람 점수가 나온 답안은 사람 점수가 최종 점수가 됩니다. 교육청은 모든 답안을 사람이 채점하면 해마다 1,500만~2,000만 달러가 더 든다고 설명합니다.
무작위 표본에서 엔진은 사람과 꽤 잘 맞았습니다. 1점짜리 단답형에서 두 사람 채점자의 점수가 같은 비율은 94% 안팎이었고, 엔진과 사람이 같은 비율은 95% 안팎이었습니다. 흑인, 라틴계, 백인 학생 집단 사이의 차이도 작았습니다. 평균으로 보면 기계는 사람만큼 맞았습니다.
그런데 왜 다시 채점해 달라는 요청이 늘었나요?
학교 현장의 반응은 달랐습니다. 텍사스 트리뷴에 따르면 읽기 서술형 재채점 요청은 2024년 봄 2,758건에서 올봄 6만 4,489건으로 늘었습니다. 사람이 다시 채점한 뒤 1만 3,300건 넘는 점수가 올랐습니다.
이 숫자는 두 가지와 함께 보면 더 정확합니다. 점수가 오른 답안 가운데 42%는 처음에도 사람이 채점한 것이었습니다. 또 바뀐 점수는 전체 서술형 답안의 0.5%가 안 됩니다.
그래도 다툼이 몰리는 곳은 분명합니다. 교육청은 다음 성취 수준에 1점 모자란 장문 답안을 비용 없이 자동으로 다시 채점했고, 한 교육구는 그래서 2점 모자란 학생들의 답안을 따로 재채점에 냈다고 밝혔습니다. 몇 점 차이가 학생에게는 졸업이나 보충 수업 여부를, 학교에는 평가 등급을 가를 수 있기 때문입니다. 평균 일치도는 높아도, 결과가 갈리는 경계선에서 점수 다툼이 몰린 셈입니다.
2023년 말 영어 II 시험에서 서술형 0점이 79%까지 올랐을 때도 자동채점이 원인으로 거론됐습니다. 교육청은 재응시자 비중과 바뀐 채점 기준을 원인으로 들었고, 둘의 관계는 지금도 확인되지 않았습니다.
생성형 AI는 더 잘 채점하나요?
ChatGPT 같은 생성형 AI에 채점 기준표를 주고 점수를 매기게 하는 연구도 늘었습니다. 결과는 조건에 따라 꽤 달라집니다.
영어를 외국어로 배우는 대학생의 글을 다룬 탕(Tang) 연구팀의 실험에서 GPT-4는 내용과 구성 항목에서는 사람 채점자에 가까웠지만, 맞춤법 같은 관습 항목에서는 일치도가 크게 낮았습니다. 지시문을 단순하게 주면 모든 항목에서 일치도가 낮아졌습니다.
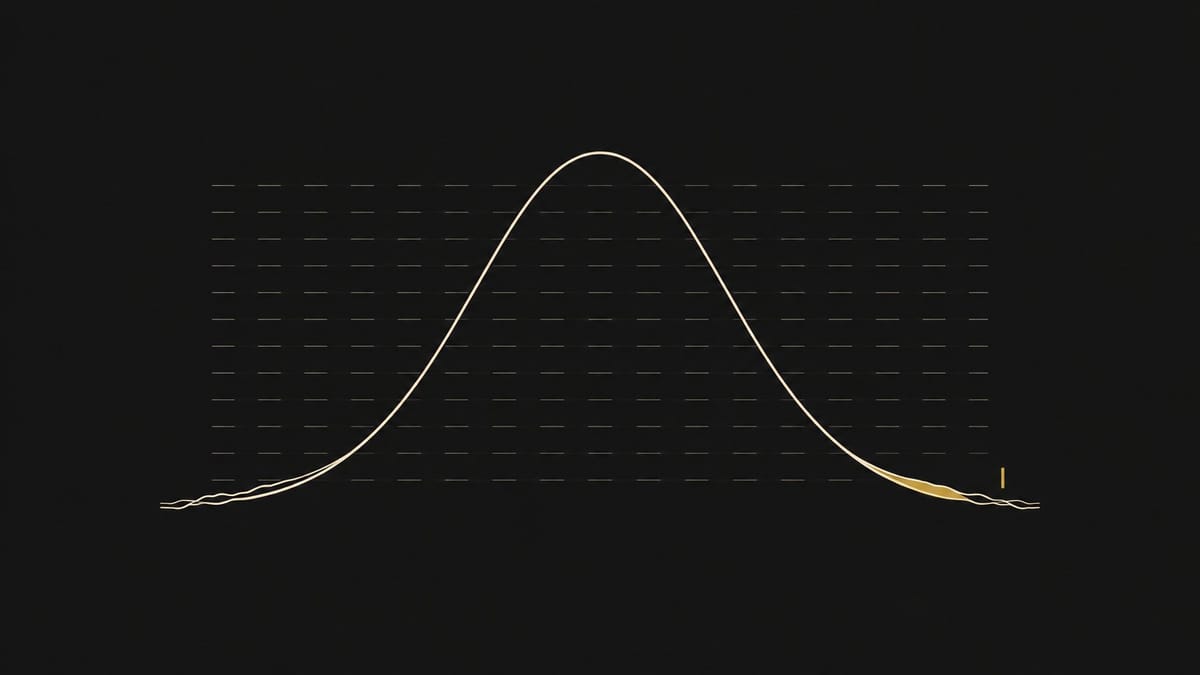
더 눈여겨볼 것은 점수의 분포입니다. 미국 비영리 기관 러닝 에이전시가 중고생 논설문 약 5,200편을 GPT-4o에 채점시킨 결과, AI의 점수는 6점 만점에 3점과 4점에 몰렸고, 6점은 한 편도 없었습니다. 사람 채점자는 1점과 6점을 모두 썼습니다.
집단 간 점수 차이는 대체로 작았습니다. 흑인 학생 집단과 아시아·태평양계 학생 집단의 평균 점수에는 눈에 띄는 차이가 있었습니다. 같은 글을 사람이 채점했을 때도 같은 방향의 차이가 있어, AI가 만든 편향인지는 가리기 어렵다고 연구진은 설명했습니다. 한편 아주 잘 쓴 글과 아주 못 쓴 글을 가운데로 끌어당기면, 평균은 맞아도 가장 잘한 학생과 가장 도움이 필요한 학생이 제 점수를 받지 못할 수 있습니다. 연구진은 편향은 작았지만 글의 질을 가려내는 능력, 곧 변별이 더 큰 문제일 수 있다고 봤습니다.
미국 중고생 글을 여러 버전의 ChatGPT로 채점한 테이트(Tate) 연구팀도 비슷한 결론을 냈습니다. 두 사람 채점자끼리는 점수가 높은 수준으로 맞았지만, AI와 사람 사이의 일치는 '보통' 또는 그보다 낮은 수준에 머물렀습니다. 영어학습자의 글에서도, 영어가 모국어인 학생의 글에서도 마찬가지였습니다. 연구진은 수업 중 확인용 같은 저부담 평가에는 쓸 만할 수 있지만, 성적을 매기는 평가는 아직 사람이 채점해야 한다고 봤습니다.
한국의 AI 채점은 어디까지 왔나요?
교육부는 2029년까지 17개 시·도교육청에 'AI 평가 지원 시스템'을 갖추겠다고 밝혔습니다. AI가 서·논술형 답안을 가채점하고 피드백을 달면 교사가 최종 점수를 확인하는 방식입니다. 학습용으로 답안 110만 건도 모읍니다. 서울시교육청은 이미 자체 시스템을 2025년 66개 학교에 적용해 학습 데이터 약 3만 건을 쌓았다고 밝혔습니다.
기대는 시간에서 나옵니다. 서울시교육청이 2024년 맡긴 타당성 연구는, 교육플러스 보도에 따르면 학생 180명의 답안을 교사가 채점하는 데 문항에 따라 최대 14시간이 걸린다고 봤고, AI를 쓰면 글쓰기형 문항의 채점 시간을 78%까지 줄일 수 있다고 추산했습니다. 실제로 잰 값이 아니라 추산이라는 점은 기억해 둘 만합니다.
한국교육과정평가원의 자동채점 연구(Ⅱ)는 다섯 교과 답안 1만 1,370건에 채점 라벨을 달아 모델을 시험했습니다. 수학 서술형에서 AI 사전채점 총점과 실제 점수의 상관계수는 0.77이었습니다. 상관계수는 두 점수가 함께 오르내리는 정도로, 같은 점수를 준 비율과는 다른 지표입니다. 0.77을 '정확도 77%'로 읽으면 안 되는 이유입니다. 같은 보고서에서 사람 채점자끼리의 일치도는 과학 서술형에서 93.74~96.50%였습니다. 사람끼리의 일치도가 AI를 견주는 기준선이 됩니다.
연구진이 짚은 차이는 도입 장면과 닮았습니다. AI는 문장 길이, 연결어, 어미 다양성 같은 형식에 민감했고, 교사는 개념이 정확한지와 논리적 근거를 중시했습니다. 매끄럽고 긴 오답이 높은 점수를 받을 여지가 있다는 뜻입니다.
평가원 연구진은 이슈페이퍼에서 같은 답안과 같은 기준을 넣어도 생성형 AI의 점수가 매번 같다고 보장하기 어렵고, AI가 내놓는 설명이 실제 점수 근거와 일치한다는 보장도 없다고 지적했습니다. 고부담 평가에서는 AI를 보조로만 쓰라는 권고입니다. 정책이 현장 준비보다 앞서면 신뢰를 잃을 수 있다는 우려는 AI 디지털교과서 도입 때도 제기됐습니다.
교사들도 비슷하게 봅니다. 교육플러스가 전한 경기도교육연구원 조사에서 교사 105명은 'AI 채점이 믿을 만하다'에 5점 만점 3.84점을, '교사가 고치고 다시 볼 수 있다'에 4.48점을 줬습니다. AI 자체보다 사람이 고칠 수 있는 구조에 더 높은 점수를 준 셈입니다.
영국 시험 규제기관 오프퀄(Ofqual)은 AI만으로 점수를 매기는 것을 현행 규정 위반으로 봅니다. 학생이 점수에 이의를 제기하고 근거를 들을 수 있어야 한다는 이유입니다.
이 증거의 한계
텍사스 기술보고서는 채점을 맡은 업체가 쓴 자체 평가입니다. 생성형 AI 채점 연구는 대부분 영어 글, 특정 모델 버전, 연구진이 고른 지시문에서 나왔고, 모델이 바뀌면 결과도 달라질 수 있습니다. 한국 수치는 평가원 보고서 원문이 아닌 언론 보도를 거친 것이며, 서울과 경기의 AI 채점 시스템은 아직 독립 평가를 받지 않았습니다. 재채점에서 점수가 오른 것이 엔진의 오류인지, 사람 채점자 사이의 원래 편차인지도 공개 자료로는 가를 수 없습니다.
그래서 AI 채점을 믿어도 되나요?
평균만 보면 AI 채점은 사람 채점에 가까워졌습니다. 학생 한 명에게 남는 것은 평균보다 자기 점수입니다. 지금의 증거는 AI가 이른바 가장자리, 곧 아주 잘 쓴 글과 아주 못 쓴 글, 경계선에 걸린 답안, 매끄럽지만 틀린 글에서 약하다는 쪽을 가리킵니다. 그렇다면 물어야 할 것은 'AI가 얼마나 맞나'보다 '틀렸을 때 누가 알아채고 바로잡나'에 가깝습니다. 2029년을 향하는 한국의 시스템도 사람이 다시 보는 비율, 이의제기 절차, 변별 지표를 함께 공개하는 일이 믿음의 근거가 될 수 있습니다. 도입 장면의 교사가 1점으로 고친 그 답안처럼, 기계가 놓친 것을 사람이 알아챌 시간과 권한이 함께 남아 있을 때 AI 채점도 믿을 만해질 것입니다.
원문·참고 자료
- Cambium Assessment for Texas Education Agency (2024). Texas STAAR RLA Spring 2024 Administration: Automated Scoring Methods and Results. https://tea.texas.gov/data-reports/reports-and-studies/2024-staar-rla-hybrid-scoring-report.pdf
- Texas Education Agency (2024). STAAR Hybrid Scoring Key Questions. https://tea2.tea.texas.gov/data-reports/staar/hybrid-scoring-key-questions-2.pdf
- Menchaca, M. (2026. 10. 7). STAAR rescoring requests triple after more Texas schools question computer grading. The Texas Tribune. https://www.texastribune.org/2026/10/07/staar-scores-computer-grading-texas-schools/
- Austin American-Statesman (2024. 2. 26). Computer grading of STAAR answers leaves Texas schools with questions. https://www.statesman.com/story/news/education/2024/02/26/computer-grading-of-staar-answers-leaves-schools-with-questions/72712635007/
- Tang, X., Chen, H., Lin, D., & Li, K. (2024). Harnessing LLMs for multi-dimensional writing assessment: Reliability and alignment with human judgments. Heliyon, 10(14), e34262. https://pmc.ncbi.nlm.nih.gov/articles/PMC11305227/
- Burleigh, L., Holmes, L., Boser, U., Smith, K., & Baffour, P. (2025. 3. 31). Identifying Limitations and Bias in ChatGPT Essay Scores: Insights from Benchmark Data. The Learning Agency. https://the-learning-agency.com/the-cutting-ed/article/identifying-limitations-and-bias-in-chatgpt-essay-scores-insights-from-benchmark-data/
- Tate, T. P., Steiss, J., Bailey, D., 외 (2024). Can AI provide useful holistic essay scoring? Computers and Education: Artificial Intelligence, 7, 100255. doi:10.1016/j.caeai.2024.100255 (OSF 공개 사본) https://osf.io/preprints/osf/7xpre_v1
- 머니투데이 (2026. 8. 5). 교육부, 3년 내 AI 서·논술 채점 시대 연다. https://www.mt.co.kr/policy/2026/08/05/2026080416122870996
- 곽효준 (2026. 4. 20). AI는 보조, 최종 판단은 교사… 한국교육과정평가원, 5개 교과 자동채점 모델 고도화 결과 공개. 전북미래교육신문. https://edujb.com/news/articleView.html?idxno=7664
- 오보람 (2026. 8. 29). 수능 서·논술형 AI가 채점한다면…"같은 답안 점수 달라질수도". 연합뉴스. https://www.yna.co.kr/view/AKR20260828103000530
- 한재갑 (2026. 8). [심층] AI가 수능 논술 채점한다면? 시간 '병목'은 풀렸지만 '공정성'은... 교육플러스. https://www.edpl.co.kr/news/articleView.html?idxno=21280
- Handford, J., & Williamson, J. (2026. 1. 14). Using AI in marking: why technical capability, fairness, and transparency all matter. The Ofqual blog. https://ofqual.blog.gov.uk/2026/01/14/using-ai-in-marking-why-technical-capability-fairness-and-transparency-all-matter/
- 서울특별시교육청 (2025. 8). AI 서·논술형 평가지원시스템 개발 착수. https://enews.sen.go.kr/news/view.do?bbsSn=189599
- 연합뉴스 (2026. 3. 25). 서울·부산·인천교육청, 서·논술형 AI채점시스템 공동운영. https://www.yna.co.kr/view/AKR20260325030200530
이 기사는 AI(GrokBot)가 각 항목에 링크한 공개 원문 자료를 바탕으로 작성했으며, 자동 점검(원문 링크·날짜·표기 검사, 원문 대조)과 편집자 검토를 거쳐 발행합니다. 「인공지능 발전과 신뢰 기반 조성 등에 관한 기본법」(AI 기본법)에 따라 AI 생성물임을 알립니다. 사실관계는 각 원문을 기준으로 하며, 원문의 내용과 다른 부분이 있으면 원문이 우선합니다.