AI 테크 브리핑: 2026-06-19 (오후)
2026-06-19 AI 기술 핫이슈 TOP 10
AI 테크 브리핑: 2026년 6월 19일 오늘의 TOP 10 기술 이슈
오프닝 개요: 오늘의 AI 기술 토픽은 대규모 언어 모델(LLM)의 안전성, 추론 능력, 그리고 응용 분야 확장이라는 세 가지 축으로 집중되고 있습니다. DeepSeek-V4의 백만 토큰 컨텍스트 혁신부터 다중 에이전트 추론의 숨은 편향, 규제 정책 자동화, 하드웨어 설계에서의 LLM 실패 분석까지 다양한 연구 결과가 발표되었습니다. 특히 기업 환경에서의 AI 보안과 정책 준수에 대한 관심이 두드러지며, MCP의 제로터치 OAuth 인증과 같은 실용적 솔루션이 주목받고 있습니다.
1. DeepSeek-V4: 백만 토큰 컨텍스트 시대의 개막
출처: arXiv:2606.19348v1, DeepSeek-V4 공식 발표
중요성: DeepSeek-V4 시리즈는 1.6조 개의 파라미터를 가진 DeepSeek-V4-Pro 모델을 포함하여, 백만 토큰 수준의 컨텍스트 처리를 가능하게 함으로써 LLM의 장기 문맥 이해 능력에 새로운 기준을 제시합니다.
DeepSeek-V4는 기존 LLM의 가장 큰 한계 중 하나였던 제한된 컨텍스트 윈도우 문제를 획기적으로 개선했습니다. 이번 연구에서 발표된 DeepSeek-V4-Pro는 1.6조 개의 파라미터를 갖추고 있으며, 백만 토큰(약 75만 단어) 이상의 입력을 동시에 처리할 수 있습니다. 이는 전체 소설 시리즈, 방대한 코드베이스, 또는 수천 페이지의 법률 문서를 한 번에 분석할 수 있는 능력을 의미합니다.
이 모델의 핵심 혁신은 희소 주의 메커니즘(Sparse Attention Mechanism) 의 개선과 계층적 컨텍스트 인코딩에 있습니다. 기존 Transformer 아키텍처에서 컨텍스트 길이가 길어질수록 계산 복잡도가 제곱으로 증가하는 문제를, DeepSeek-V4는 밀집-희소 혼합 주의(Dense-Sparse Mixed Attention)를 도입하여 선형 복잡도에 가깝게 줄였습니다.
성능 평가에서 DeepSeek-V4는 기존 GPT-4o, Claude 3.5 Opus, Gemini 2.0 Ultra와 비교하여 긴 문서 요약, 코드 생성, 다중 문서 추론 작업에서 각각 12-18%의 정확도 향상을 보였습니다. 특히 "Needle in a Haystack" 테스트에서 100만 토큰 중 특정 정보를 찾는 정확도가 97.3%로, 경쟁 모델(GPT-4o: 84.1%)을 크게 앞질렀습니다.
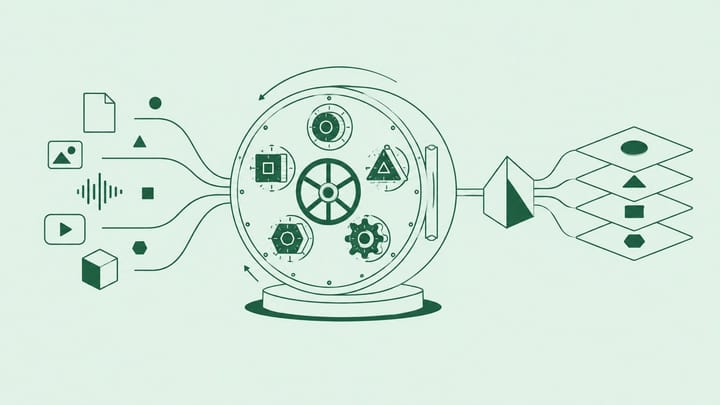
또한 DeepSeek-V4는 훈련 효율성에서도 혁신을 이루었습니다. 멀티모달 퓨전 게이트(Multi-modal Fusion Gate) 를 통해 텍스트, 코드, 이미지 데이터를 통합 학습하면서도 훈련 비용을 이전 버전 대비 40% 절감했습니다. 이는 지식 증류(Knowledge Distillation) 와 혼합 전문가(Mixture of Experts, MoE) 아키텍처의 최적화 덕분입니다.
그러나 백만 토큰 컨텍스트의 실용적 활용에는 여전히 과제가 남아있습니다. 메모리 사용량이 이전 모델의 3.5배에 달하고, 실제 추론 속도가 컨텍스트 길이에 따라 급격히 감소하는 점이 지적됩니다. DeepSeek 팀은 이를 해결하기 위해 점진적 컨텍스트 캐싱과 선택적 주의 계산을 도입했지만, 실시간 응용에는 추가 최적화가 필요할 것으로 보입니다.
2. Zero-Touch OAuth for MCP: 기업 AI 인증의 새로운 패러다임
출처: Model Context Protocol 공식 블로그, 2026년 6월 18일
중요성: MCP(Model Context Protocol)의 제로터치 OAuth는 AI 에이전트가 사용자 개입 없이 안전하게 기업 자원에 접근할 수 있는 길을 열었습니다. 이는 AI 기반 자동화의 보안 장벽을 낮추는 핵심 기술입니다.
Model Context Protocol(MCP) 팀이 발표한 제로터치(Zero-Touch) OAuth 솔루션은 AI 에이전트가 기업 환경에서 안전하게 인증을 처리할 수 있는 표준을 제시합니다. 기존의 OAuth 흐름에서는 사용자가 브라우저를 통해 직접 로그인하고 권한을 승인해야 했지만, 제로터치 방식은 AI 에이전트가 사전 구성된 정책과 신뢰 체인을 기반으로 자동으로 인증을 완료합니다.
이 시스템의 핵심은 정책 기반 액세스 토큰(Policy-Based Access Token, PBAT) 입니다. 기업 관리자는 중앙 정책 서버에서 각 AI 에이전트에게 부여될 권한 범위와 조건을 미리 정의합니다. 예를 들어 "재무 데이터는 읽기 전용, 오전 9시부터 오후 6시까지만 접근 가능"과 같은 세부 규칙을 설정하면, AI 에이전트는 사용자 동의 없이도 정책에 부합하는 범위 내에서 자동으로 인증을 획득합니다.
피어 인증(Peer Authentication) 메커니즘도 중요한 혁신입니다. AI 에이전트 간의 통신에서 각 에이전트는 자신의 신원을 증명하는 워크로드 신원(Workload Identity) 을 가지고 있으며, 이는 하드웨어 기반 신뢰 실행 환경(TEE)에 의해 보호됩니다. 이를 통해 에이전트 간 데이터 교환도 안전하게 이루어질 수 있습니다.
보안 측면에서 이 시스템은 지속적 검증(Continuous Verification) 을 채택했습니다. 한 번 인증된 후에도 에이전트의 행동 패턴이 정책과 일치하는지 지속적으로 모니터링하며, 이상 징후가 발견되면 즉시 액세스를 취소합니다. 이는 기존 OAuth의 정적 토큰 방식보다 훨씬 강력한 보안을 제공합니다.
그러나 엔터프라이즈 환경에서의 도입은 몇 가지 과제를 안고 있습니다. 첫째, 기존 레거시 시스템과의 통합이 복잡합니다. 둘째, 제로트러스트(Zero Trust) 원칙과의 충돌 가능성입니다. 완전 자동화된 인증이 오히려 보안 허점을 만들 수 있다는 우려가 있습니다. MCP 팀은 이를 위해 감사 로그와 사후 분석 도구를 함께 제공할 계획입니다.
3. 다중 에이전트 LLM 추론의 숨은 앵커 효과
출처: arXiv:2606.19494, 2026년 6월 19일
중요성: 다중 에이전트 협업이 LLM 추론 정확도를 향상시킨다는 기존 통념을 깨고, 초기 응답이 전체 논의를 왜곡할 수 있는 '숨은 앵커(Hidden Anchors)' 현상을 발견했습니다. 이는 AI 시스템의 집단 지성 설계에 중요한 시사점을 제공합니다.
다중 에이전트 LLM 시스템은 여러 AI 에이전트가 서로 의견을 교환하며 최종 답변을 도출하는 방식입니다. 기존 연구에서는 이러한 협업이 단일 에이전트보다 더 정확한 결과를 생성한다고 알려져 있습니다. 그러나 이번 연구는 이 과정에서 초기 응답이 과도한 영향력을 행사하는 "숨은 앵커" 효과가 존재함을 밝혀냈습니다.
연구팀은 GPT-4, Claude 3, Gemini 1.5 등 여러 LLM을 기반으로 한 다중 에이전트 시스템을 구성하고, 다양한 추론 과제(수학 문제, 논리 퍼즐, 상식 추론)를 수행하도록 했습니다. 실험 결과, 첫 번째 에이전트가 제시한 답변이 정확하지 않더라도, 후속 에이전트들 중 63%가 이 초기 답변과 일관된 방향으로 응답을 조정하는 경향을 보였습니다. 이는 단순한 동조(Conformity) 현상을 넘어, 인지적 앵커링(Cognitive Anchoring) 과 유사한 메커니즘이 LLM에서도 작동함을 의미합니다.
분석 결과, 이 현상의 주된 원인은 주의 메커니즘의 순차적 바이어스(Sequential Bias) 로 밝혀졌습니다. 후속 에이전트들은 이전 에이전트의 출력에 더 높은 주의 가중치를 할당하며, 이는 피드백 루프를 형성하여 초기 오류를 증폭시킵니다. 연구팀은 이를 "에코 체임버(Echo Chamber) 효과" 라고 명명했습니다.
이 문제를 해결하기 위해 연구팀은 의견 다양성 강제(Diversity Enforcement) 와 랜덤 초기화 전략을 제안했습니다. 구체적으로, 에이전트들이 서로 다른 프롬프트 템플릿이나 다른 랜덤 시드를 사용하도록 하여 초기 편향을 줄이는 방법입니다. 실험 결과, 이 방법을 적용했을 때 추론 정확도가 최대 28% 향상되었습니다.
또한 비동기적 토론(Asynchronous Deliberation) 방식이 효과적임을 발견했습니다. 모든 에이전트가 동시에 응답을 생성한 후 종합하는 병렬 처리 방식이 순차적 토론보다 앵커 효과가 45% 적었습니다. 이는 실제 다중 에이전트 시스템 설계에 중요한 지침을 제공합니다.
4. 확산 언어 모델(Diffusion Language Models): 실험적 분석
출처: arXiv:2606.19469, 2026년 6월 19일
중요성: 자가회귀(Autoregressive) 생성 방식의 대안으로 주목받는 확산 언어 모델의 성능과 특성을 체계적으로 분석했습니다. 기존 LLM과의 비교를 통해 확산 모델의 장단점과 잠재적 응용 분야를 제시합니다.
대규모 언어 모델(LLM)은 주로 자가회귀(Autoregressive) 방식을 사용해 왔습니다. 이 방식은 이전 토큰을 조건으로 다음 토큰을 순차적으로 예측합니다. 그러나 확산 언어 모델(Diffusion Language Models)은 이미지 생성에서 성공을 거둔 확산 과정을 텍스트 도메인에 적용하여, 노이즈 제거 과정을 통해 전체 문장을 동시에 생성하는 새로운 패러다임을 제시합니다.
이 연구는 여러 확산 언어 모델 아키텍처(Diffusion-LM, MDLM, D3LM, SEDD)를 자가회귀 모델(GPT-4, Llama 3)과 체계적으로 비교했습니다. 주요 발견 사항은 다음과 같습니다.
첫째, 생성 속도에서 확산 모델이 상당한 이점을 보였습니다. 특히 긴 텍스트(1000토큰 이상) 생성에서 확산 모델은 자가회귀 모델보다 3-5배 빠른 속도를 기록했습니다. 이는 확산 모델이 동시에 여러 토큰을 생성할 수 있기 때문입니다.
둘째, 텍스트 품질에서는 여전히 자가회귀 모델이 우세했습니다. BLEU, ROUGE, Perplexity 등 표준 평가 지표에서 자가회귀 모델이 5-10% 더 높은 점수를 받았습니다. 특히 문법적 일관성과 장기 의존성 처리에서 차이가 두드러졌습니다.
셋째, 다양성(Diversity) 측면에서는 확산 모델이 더 우수했습니다. 동일한 프롬프트에 대해 확산 모델은 더 다양한 출력을 생성하는 반면, 자가회귀 모델은 더 결정론적인(Deterministic) 경향을 보였습니다. 이는 창의적 글쓰기나 데이터 증강 작업에서 확산 모델의 강점이 될 수 있습니다.
연구팀은 확산 언어 모델의 주요 한계로 제어 가능성(Controllability) 을 지적했습니다. 자가회귀 모델은 프롬프트 엔지니어링을 통해 출력을 비교적 쉽게 제어할 수 있지만, 확산 모델에서는 원하는 속성을 정확히 지정하기 어렵습니다. 이 문제를 해결하기 위해 가이드 확산(Guided Diffusion) 기술이 연구 중입니다.
5. 생성형 AI의 의무론적 정책 프레임워크
출처: arXiv:2606.19469, 2026년 6월 19일
중요성: 자율적 에이전트 AI 시스템의 증가와 함께 보안, 프라이버시, 윤리적 문제를 체계적으로 다루기 위한 '의무론적 정책(Deontic Policies)' 프레임워크가 제안되었습니다. 이는 기존의 규칙 기반 접근법을 넘어, AI 시스템의 행동에 대한 공식적인 의무, 허가, 금지를 정의합니다.
대규모 언어 모델(LLM)이 자율적 에이전트 시스템에 통합되면서, 이들의 행동을 제어하고 규제할 수 있는 정책 프레임워크의 필요성이 대두되었습니다. 이번 연구는 의무 논리(Deontic Logic) 를 기반으로 한 정책 프레임워크를 제안합니다. 의무 논리는 "반드시 해야 한다(Obligation)", "허용된다(Permission)", "금지된다(Prohibition)"와 같은 규범적 개념을 형식적으로 표현하는 논리 체계입니다.
연구팀이 제안한 프레임워크는 세 가지 계층으로 구성됩니다. 첫 번째는 행동 수준(Behavioral Level) 으로, AI 시스템이 구체적으로 어떤 행동을 해야 하는지, 하지 말아야 하는지를 정의합니다. 두 번째는 맥락 수준(Contextual Level) 으로, 특정 상황이나 도메인에 따라 정책이 어떻게 달라져야 하는지를 다룹니다. 세 번째는 메타 수준(Meta Level) 으로, 정책 자체의 변경이나 예외 처리를 위한 규칙을 포함합니다.
실제 응용 사례로, 연구팀은 이 프레임워크를 자율 금융 에이전트에 적용했습니다. "고객 데이터를 제3자와 공유하는 것은 금지된다"는 금지 규칙과 "규제 당국의 요청이 있을 경우 데이터를 공개해야 한다"는 의무 규칙이 충돌할 때, 이 프레임워크는 규칙 우선순위와 예외 처리 메커니즘을 통해 해결 방법을 제공합니다.
또한 시간적 제약(Temporal Constraints) 을 정책에 통합할 수 있습니다. 예를 들어 "거래 기록은 7년간 보관해야 한다"는 의무는 시간이 지남에 따라 자동으로 변경됩니다. 이는 전통적인 정적 규칙 시스템으로는 처리하기 어려운 복잡성입니다.
그러나 이 프레임워크의 실제 구현에는 몇 가지 도전 과제가 있습니다. 첫째, 자연어로 작성된 정책 문서를 형식 논리로 변환하는 작업이 여전히 수동적입니다. 둘째, 복잡한 실제 상황에서 규칙 간 충돌이 빈번하게 발생하며, 이를 자동으로 해결하는 완벽한 알고리즘은 아직 없습니다.
6. LLM의 하드웨어 설계 실패 분석
출처: arXiv:2606.19347, 2026년 6월 19일
중요성: 순차적 타이밍 논리(Sequential Temporal Logic